基于内容的图像检索(Content-based image retrieval,CBIR)是计算机视觉领域通过分析图像视觉特征实现相似内容检索的技术分支,1992年由T.Kato提出 。该系统通过提取图像颜色、纹理、形状等低层视觉特征构建特征库,允许用户输入查询图像,采用相似度匹配算法比对数据库特征,典型流程包括特征建模、索引构建和交互反馈 。
与传统基于文本的图像检索(依赖图片名称、文字描述和索引关系)不同,CBIR直接分析视觉内容实现检索。其核心技术涵盖颜色直方图、颜色相关图、纹理共生矩阵等特征提取方法,以及Manhattan距离、加权Euclidean距离等相似度度量算法 。由于计算机视觉与图像语义理解的差异,该技术存在底层特征与高层语义之间的“语义鸿沟”问题 。部分系统通过引入相关反馈机制优化检索结果 。
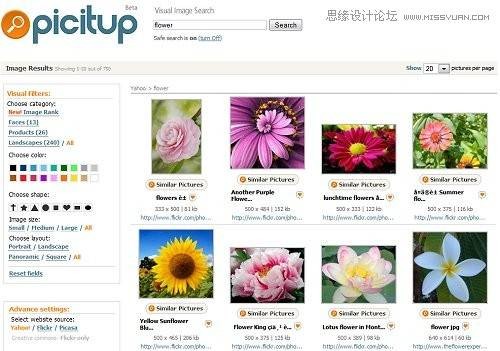
该技术自提出后被广泛应用于图像数据库检索,Google Similar Images、百度识图等主流搜索引擎均推出相关产品 。IBM的QBIC系统和MIT的Photobook系统是早期典型应用案例 。经过近30年发展,CBIR已在统计学、模式识别、信号处理等多个领域产生重要影响。
想要了解更多“基于内容的图像检索”的信息,请点击:基于内容的图像检索百科